Rychlejší inference jazykových modelů: Jak si vedou MTP, DSpark a DFlash 2
Obsah
- Čtyři varianty, jeden model a jedno GPU
- V čem se liší jednotlivé architektury spekulativního dekódování
- DFlash 2 vede do čtyř uživatelů
- Vyšší celkový výkon nemusí znamenat rychlejší odpověď
- DSpark a DFlash 2 si při dlouhém kontextu vedou podobně
- Jak se zrychlení mění se zátěží
- Výhody a nevýhody jednotlivých variant
- Testovací prostředí a kompletní výsledky
- Kterou variantu zvolit pro vaše nasazení
- Shrnutí: Jak zrychlit generování na stávajícím GPU
Související
Pomalé generování tokenů a rostoucí latence při práci s dlouhým kontextem dokážou výrazně omezit využitelnost jazykového modelu. Pomoci mohou různé metody akcelerace. I klasické MTP může proti běžnému provozu přinést znatelné zrychlení. O co nejvyšší rychlost se však ucházejí také pokročilejší přístupy DSpark a DFlash 2. Který z nich si v našich benchmarcích vedl lépe a proč neexistuje univerzální řešení pro všechny typy úloh? V detailním srovnání na kartě RTX PRO 6000 Blackwell ukážeme, kdy sáhnout po jednotlivých metodách a jak z dostupného hardwaru získat co nejlepší výkon.
Čtyři varianty, jeden model a jedno GPU
Všechny varianty jsme testovali se stejným modelem Qwen3.8-27B-FP8 v prostředí SGLang na jedné kartě NVIDIA RTX PRO 6000 Blackwell s 96 GB pamětí. Měřili jsme rychlost generování při sdíleném vytížení serveru i při zpracování dlouhého kontextu.
Srovnali jsme běžné generování bez spekulativního dekódování, Eagle MTP s návrhovou částí integrovanou v Qwenu a dvě metody s externím pomocným modelem. DSpark vytváří návrh postupně, token po tokenu. Když pomocný model dospěje na hranici svého odhadu, předá návrh hlavnímu modelu k ověření. DFlash 2 naproti tomu navrhuje celý blok tokenů najednou a hlavní model jej ověří v jediném kroku.
V čem se liší jednotlivé architektury spekulativního dekódování
Zatímco princip zůstává stejný (ověřit více kandidátů v jednom cyklu), zásadní rozdíl je v nárocích na správu modelů. Eagle MTP má pomocnou část integrovanou přímo v těle Qwenu. Naopak DSpark a DFlash 2 vyžadují běh samostatného pomocného modelu, který sice zabere další část paměti GPU, ale nabízí pokročilejší strategie předpovídání.
DFlash 2 vede do čtyř uživatelů
U firemního AI API rozhoduje také to, kolik požadavků server obslouží současně. Graf porovnává celkový výkon při kontextu o délce 20 000 tokenů. Jeden uživatel v tomto měření představuje jeden právě generující požadavek.
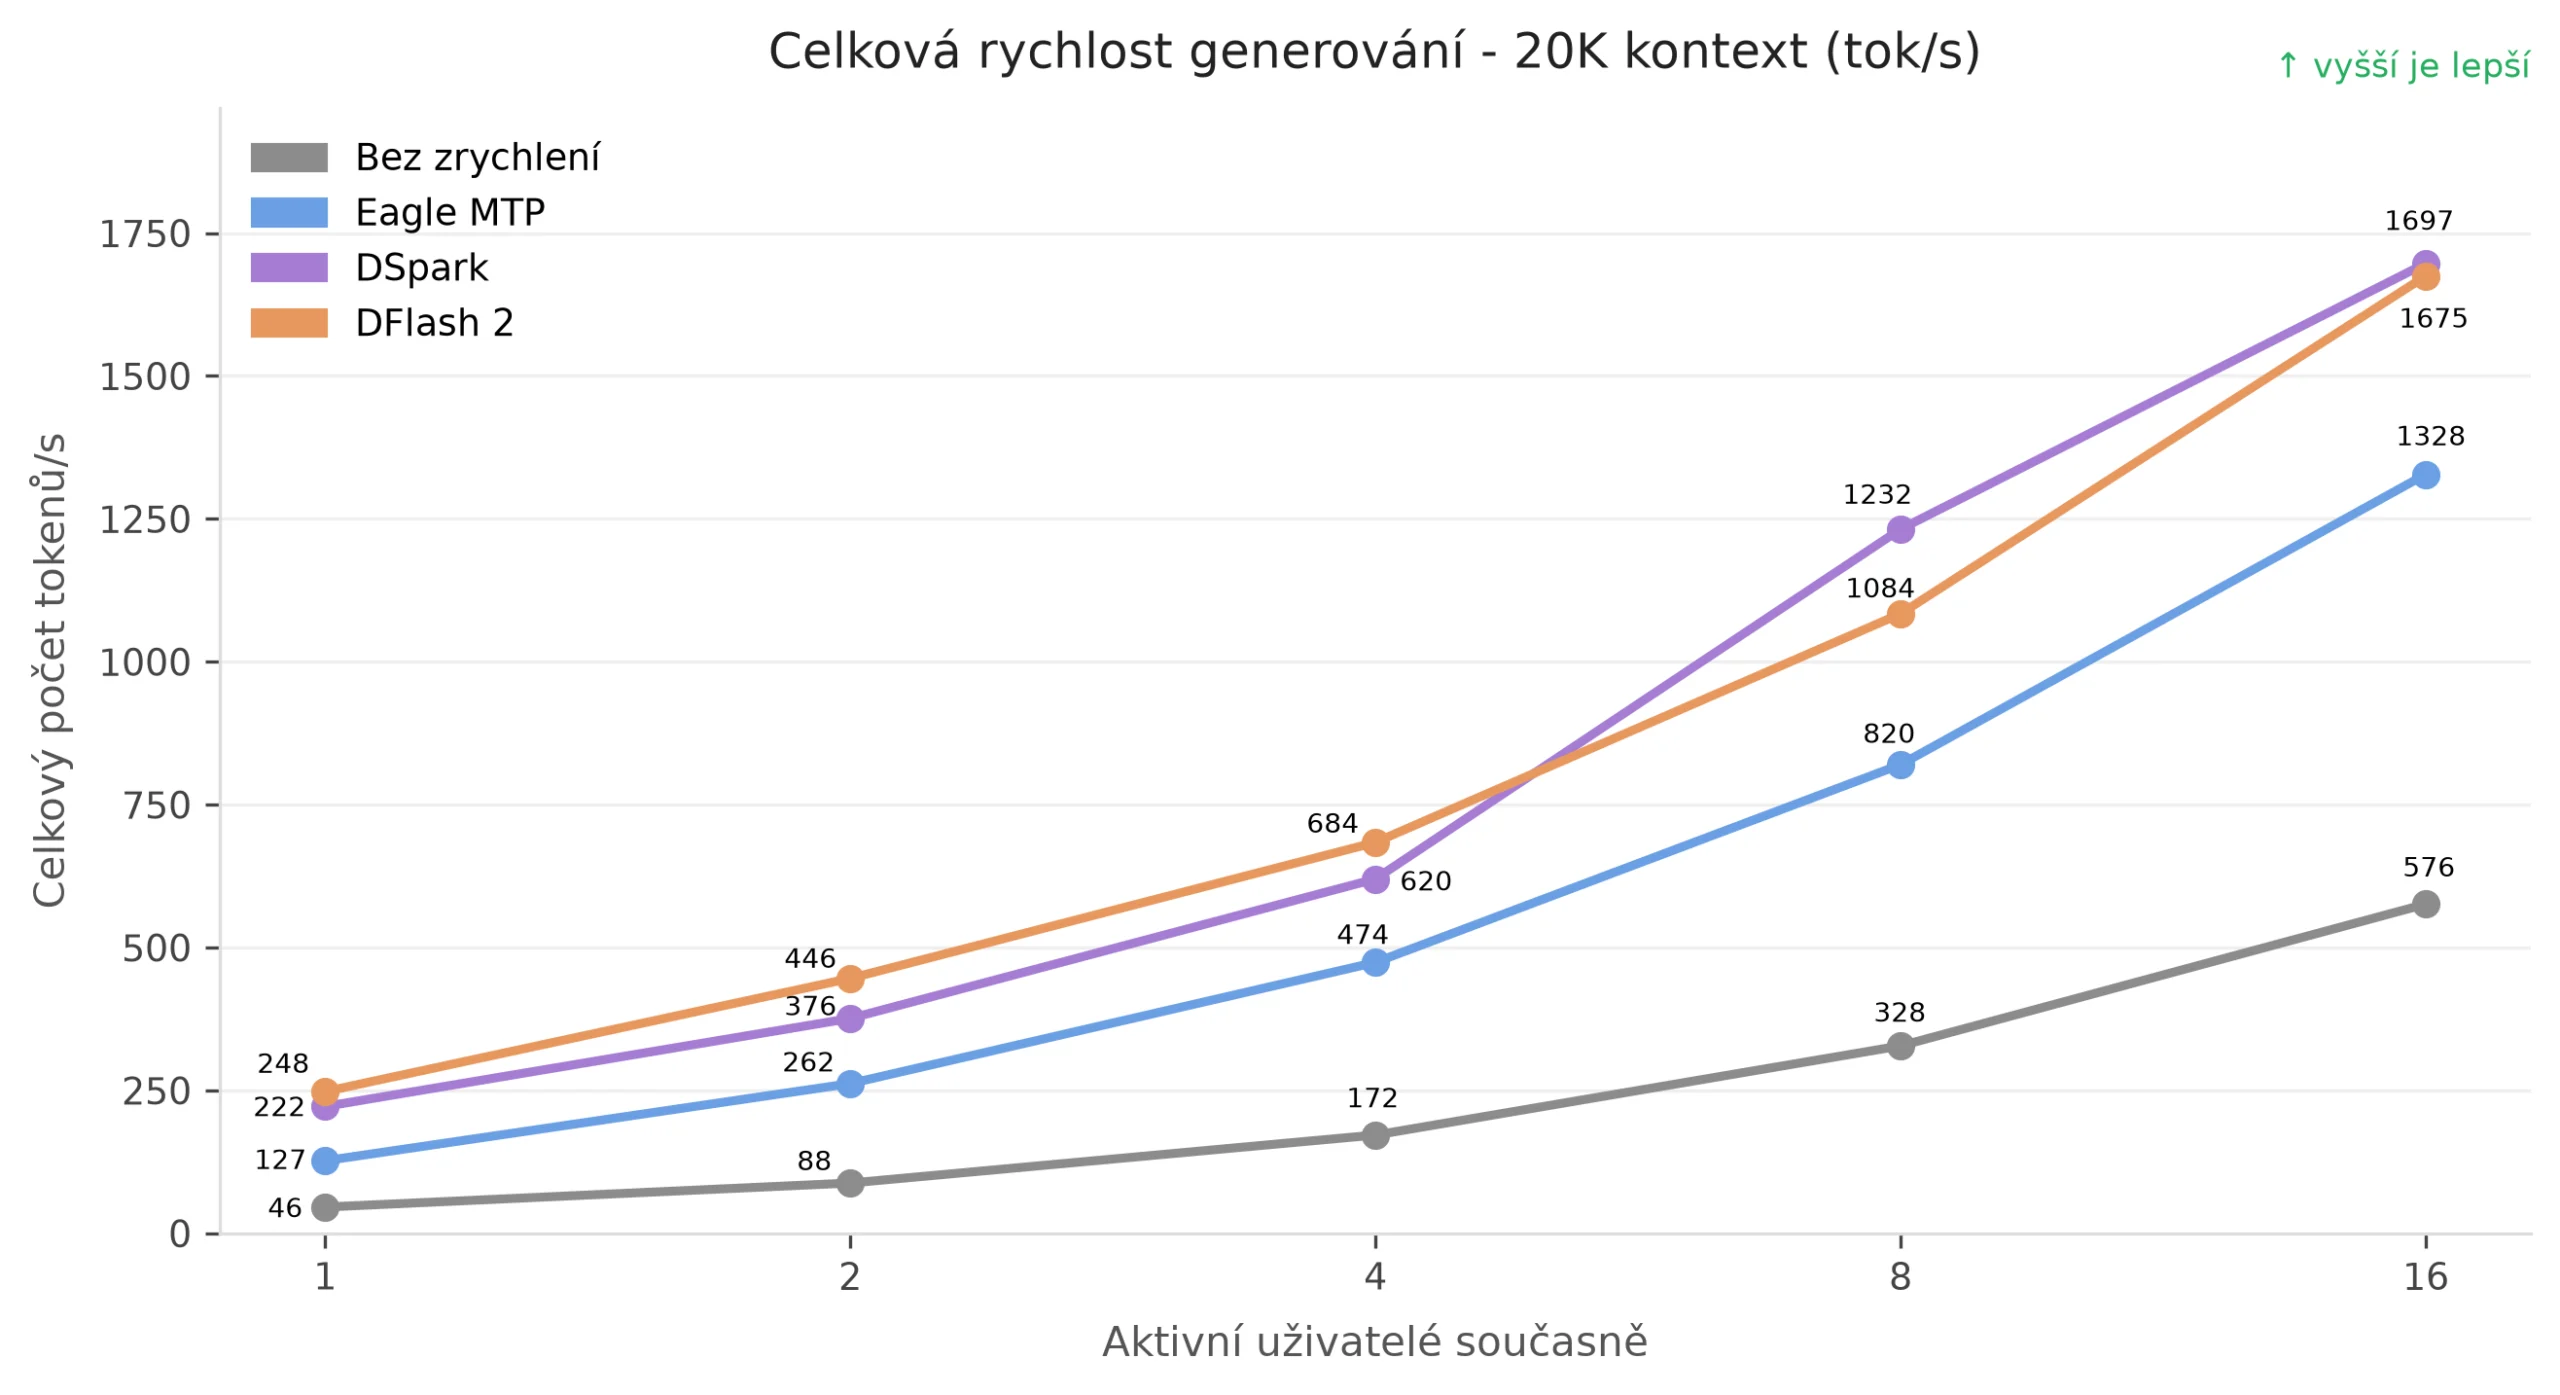
Do čtyř současných požadavků dosahuje nejvyššího celkového výkonu DFlash 2. Od osmi požadavků přebírá vedení DSpark; při nejvyšší zátěži jsou obě metody téměř vyrovnané. Eagle MTP za nimi zaostává, všechny tři metody však výrazně překonávají generování bez zrychlení.
Vyšší celkový výkon nemusí znamenat rychlejší odpověď
Celkový výkon serveru ukazuje, kolik tokenů vygenerují všechny požadavky dohromady. Při souběžném provozu se ale o výkon dělí více uživatelů. Druhý graf proto zachycuje průměrnou rychlost generování na jednoho uživatele.
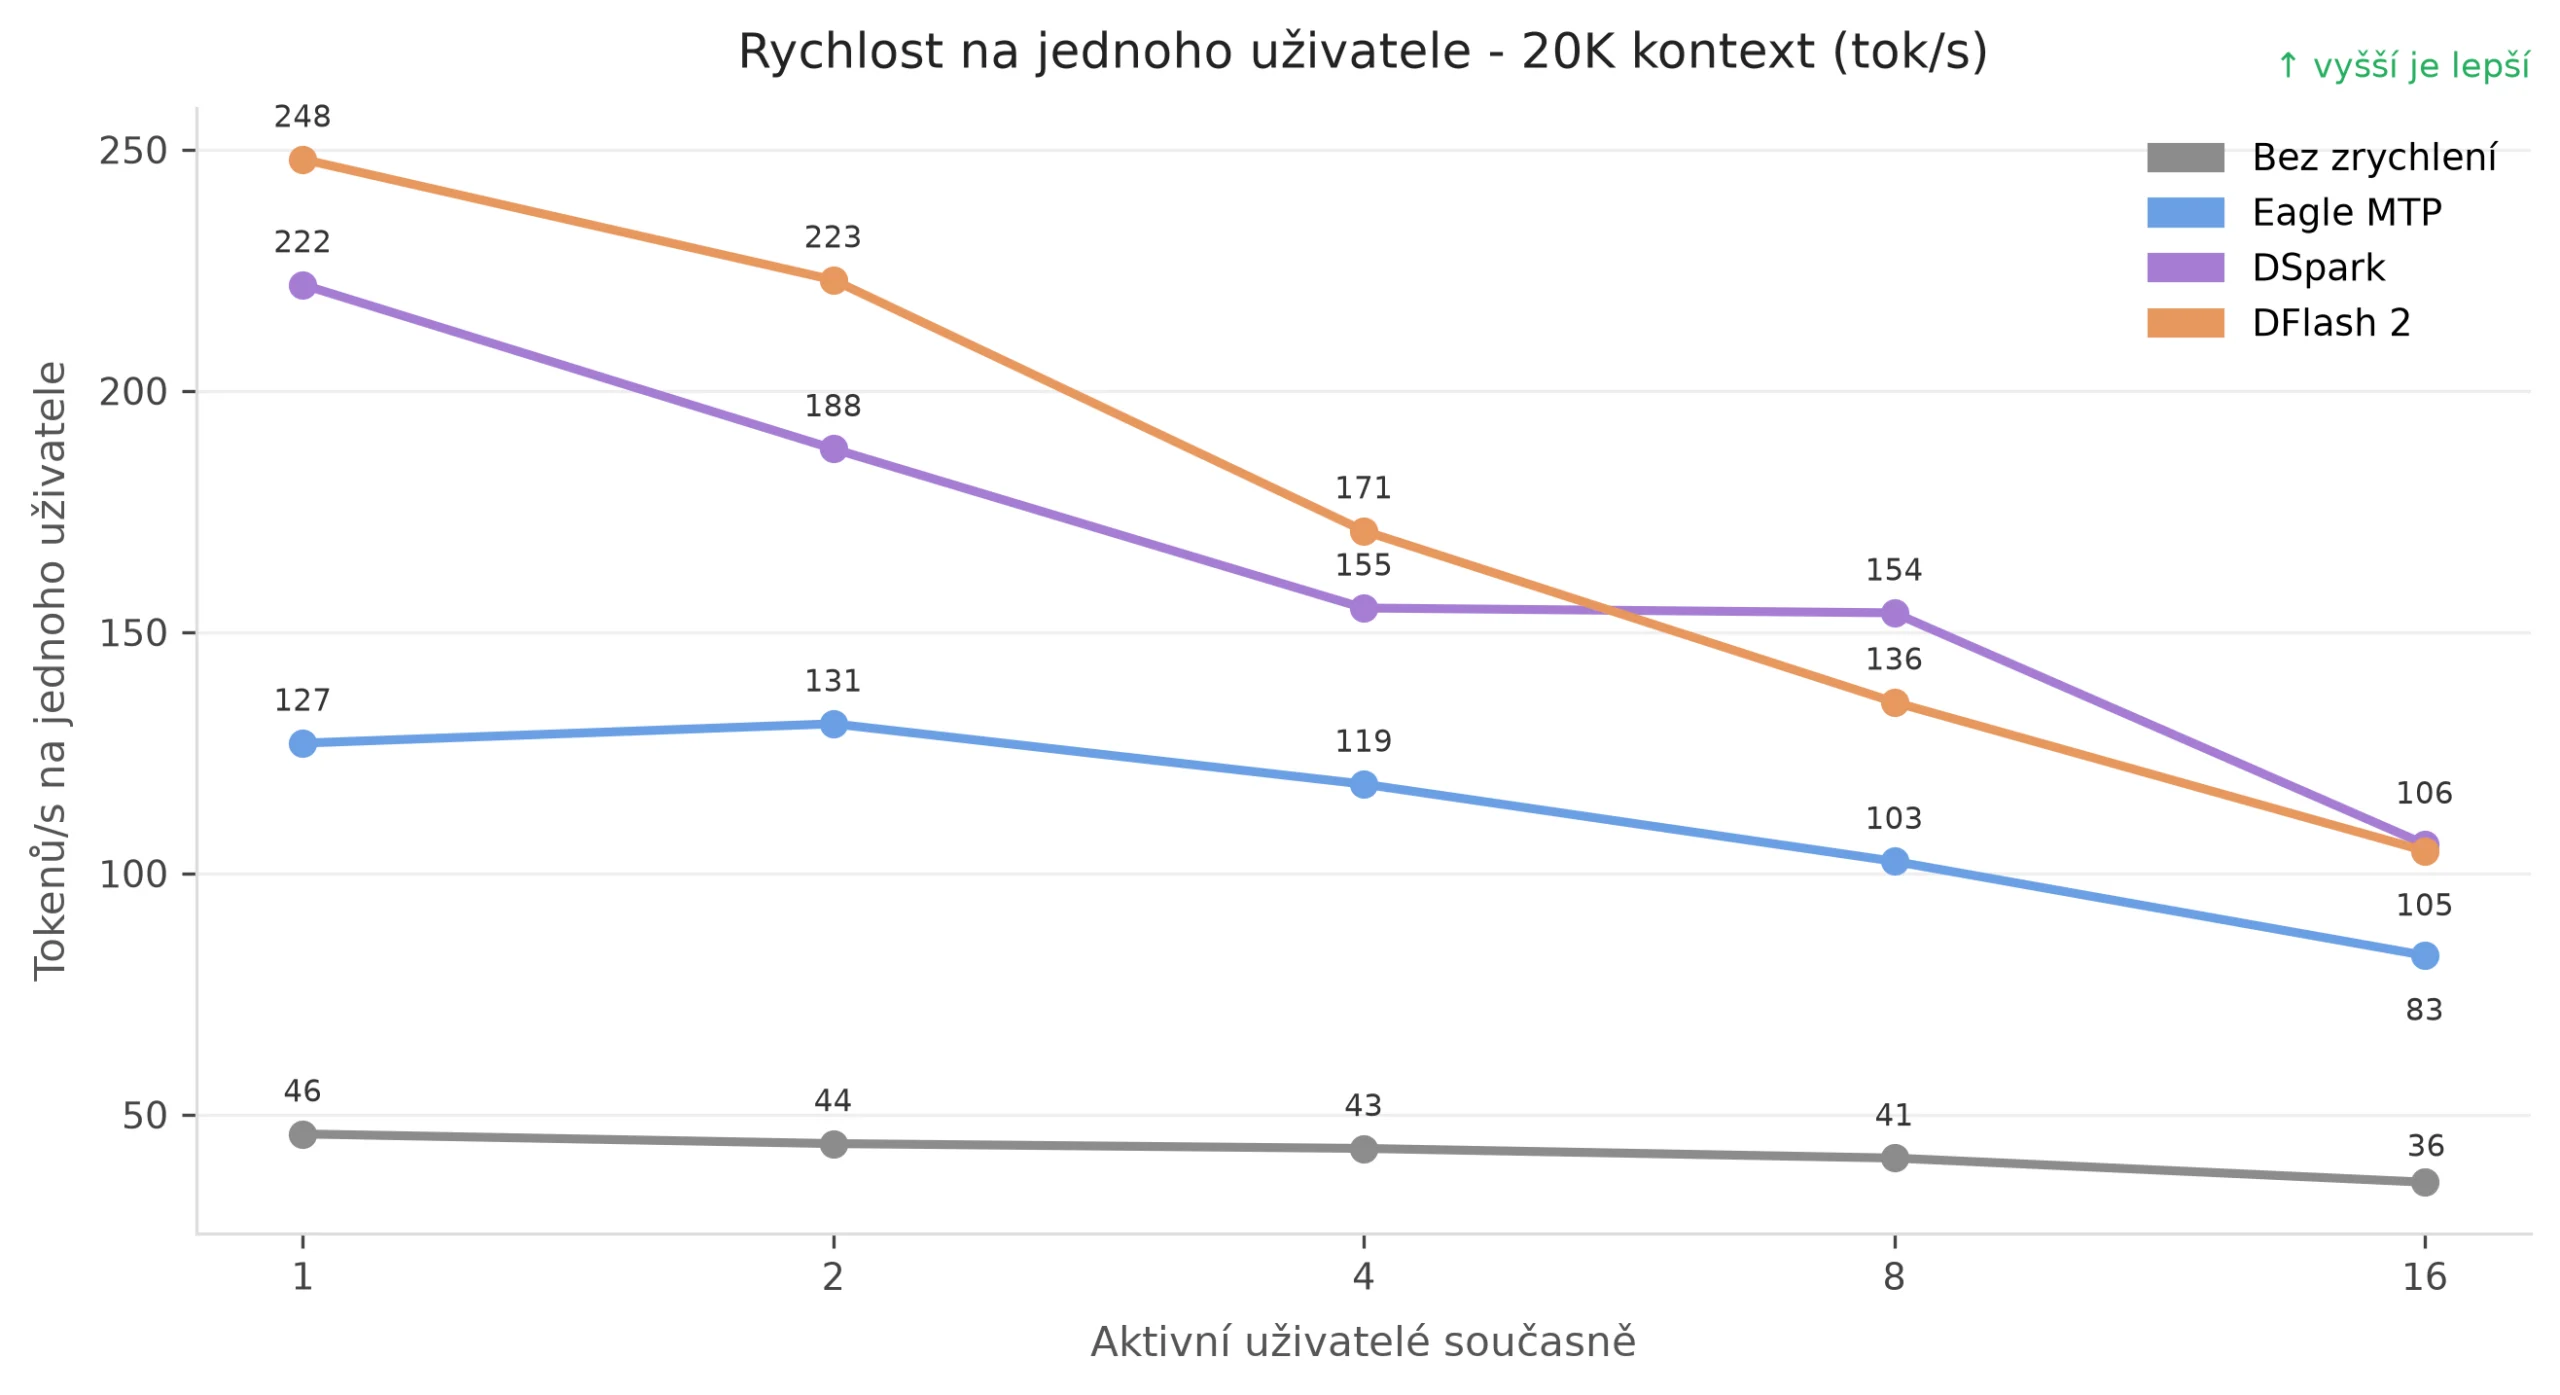
DFlash 2 dosahuje nejvyšší rychlosti při menším počtu současných požadavků. DSpark si mezi čtyřmi a osmi uživateli udržuje téměř stejné tempo na jednoho uživatele. Při nejvyšší zátěži se obě metody výkonem sbližují a zůstávají výrazně rychlejší než Eagle MTP i generování bez zrychlení.
DSpark a DFlash 2 si při dlouhém kontextu vedou podobně
U dlouhých dokumentů nebo rozsáhlého kódu může být důležité, jak se metoda akcelerace chová při zvětšujícím se kontextu. Porovnali jsme rychlost jednoho požadavku při kontextu o délce 20 000 a 200 000 tokenů.
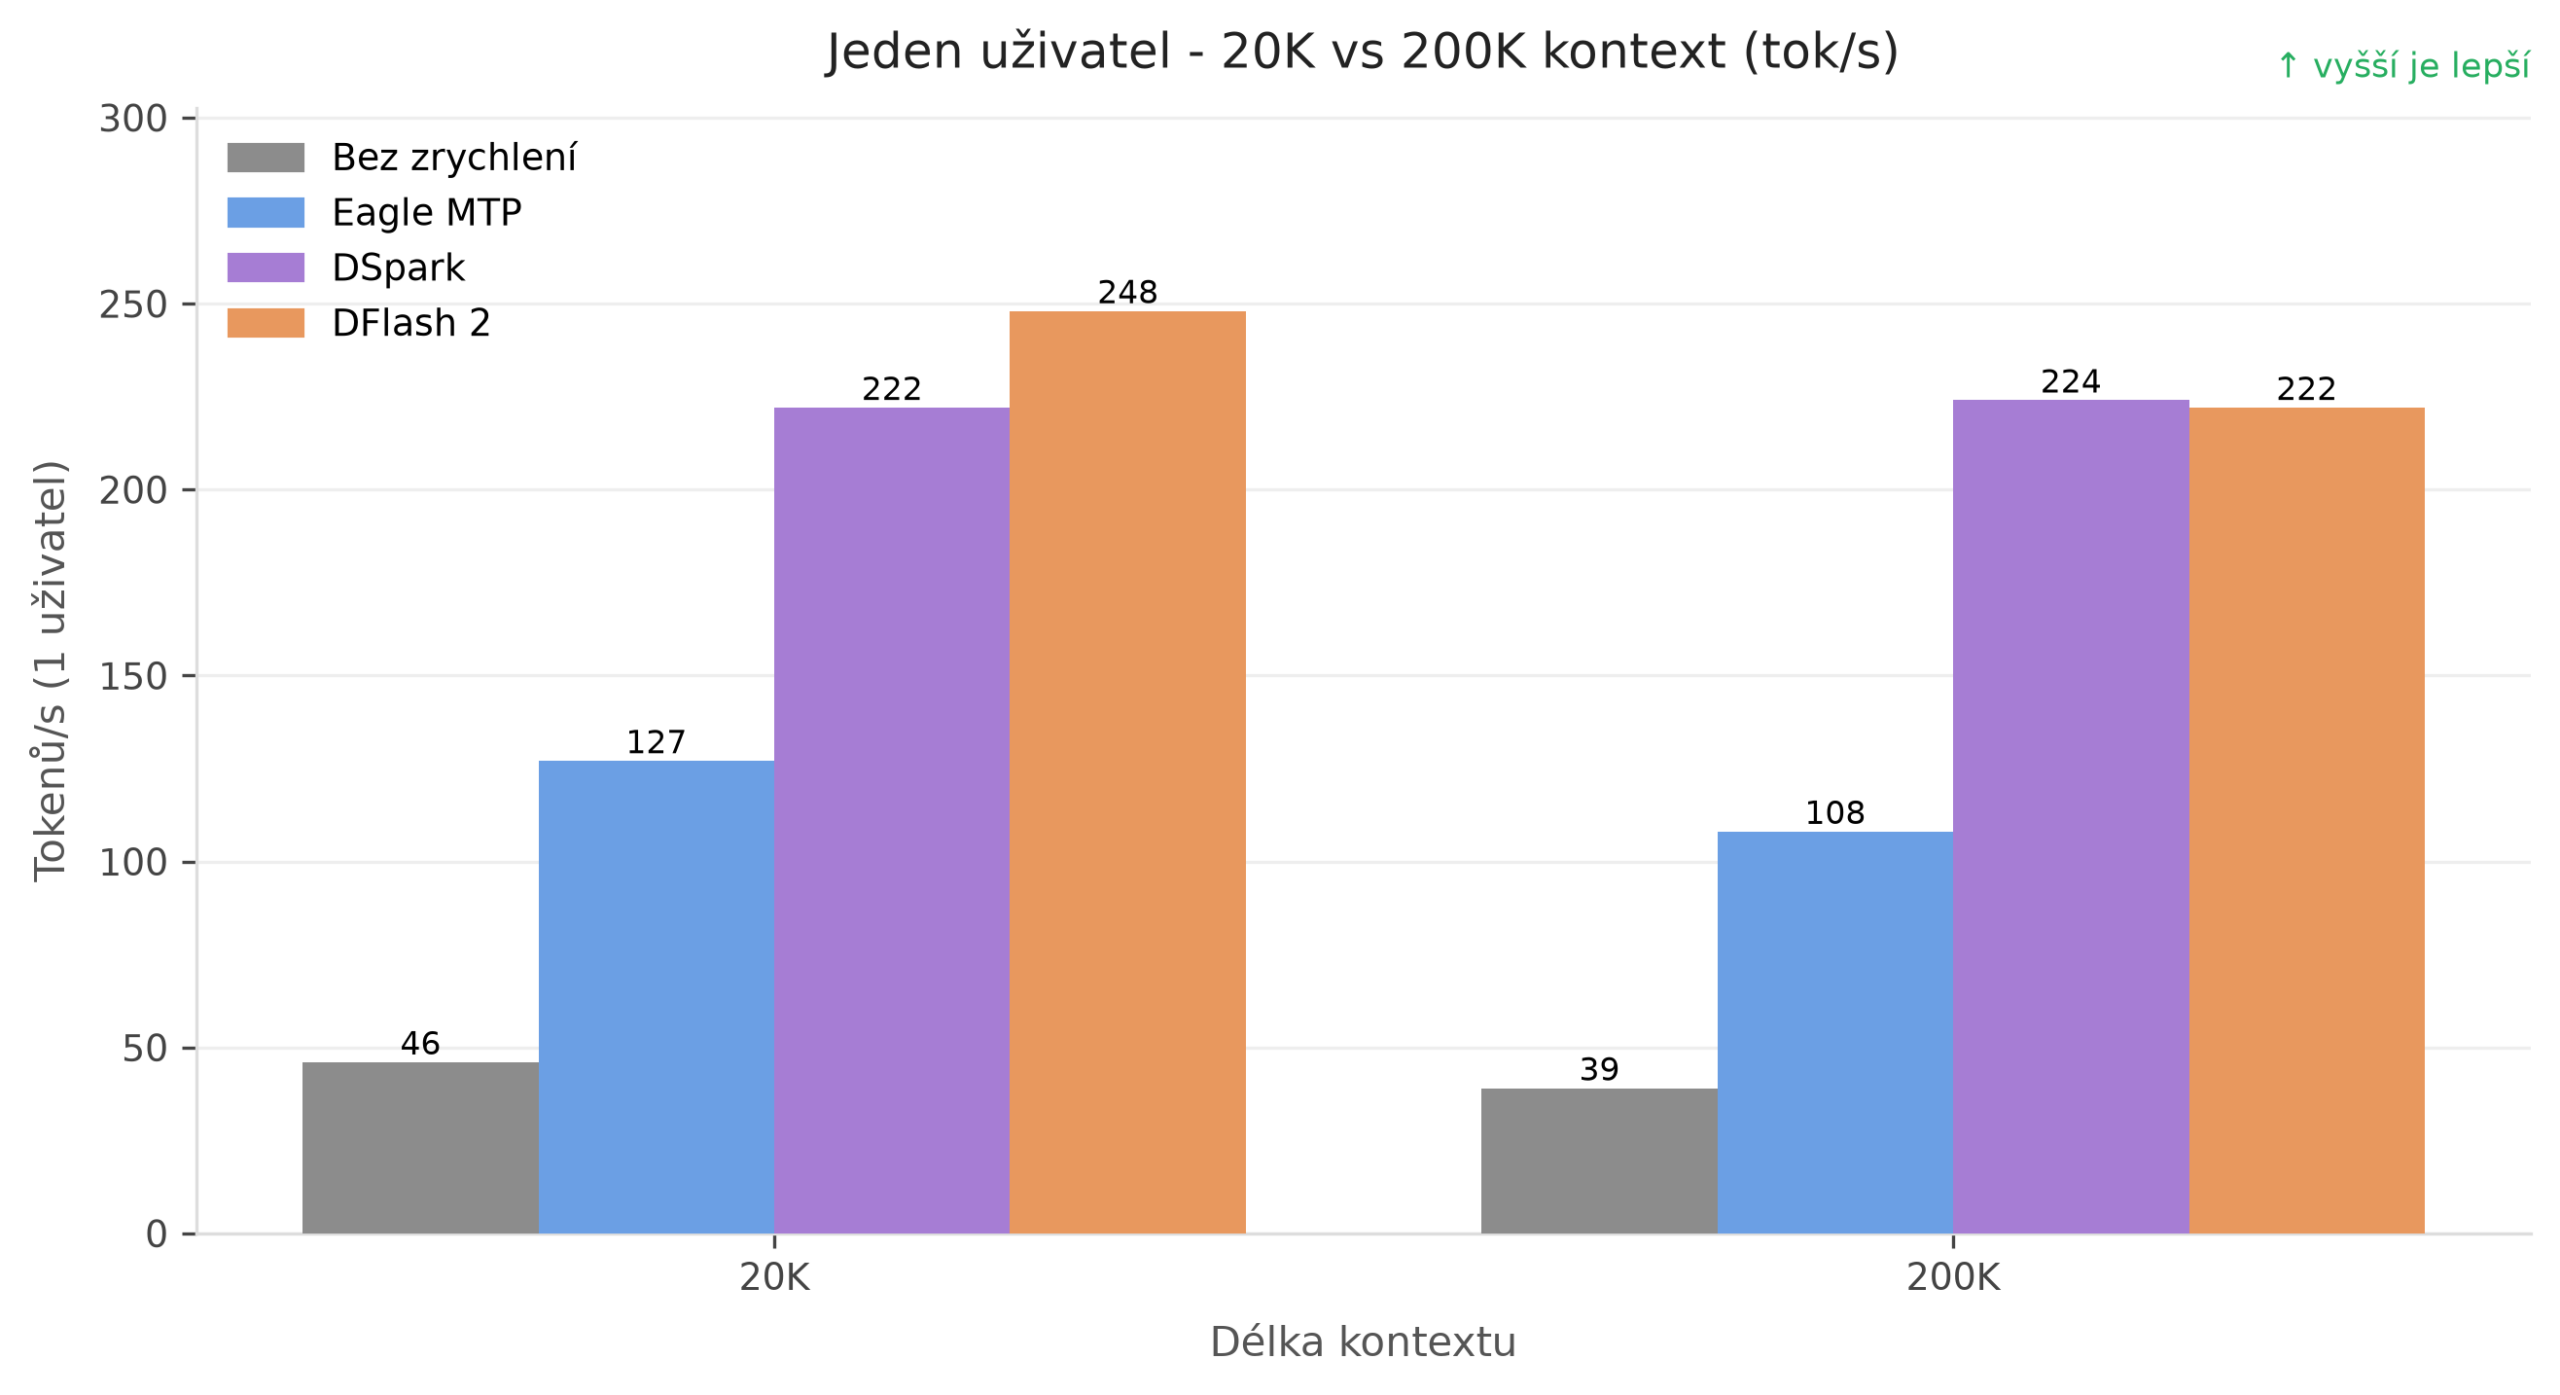
Při kratším vstupu vede DFlash 2. S dlouhým kontextem se jeho výkon vyrovnává DSparku, který si udržel téměř stejnou rychlost. Ostatní varianty mírně zpomalily. Při kontextu 200 000 tokenů generovaly obě externí metody přibližně 5,7krát rychleji než varianta bez zrychlení.
Jak se zrychlení mění se zátěží
Další graf ukazuje, kolikanásobně rychleji jednotlivé metody generují oproti variantě bez zrychlení při stejném počtu souběžných požadavků.
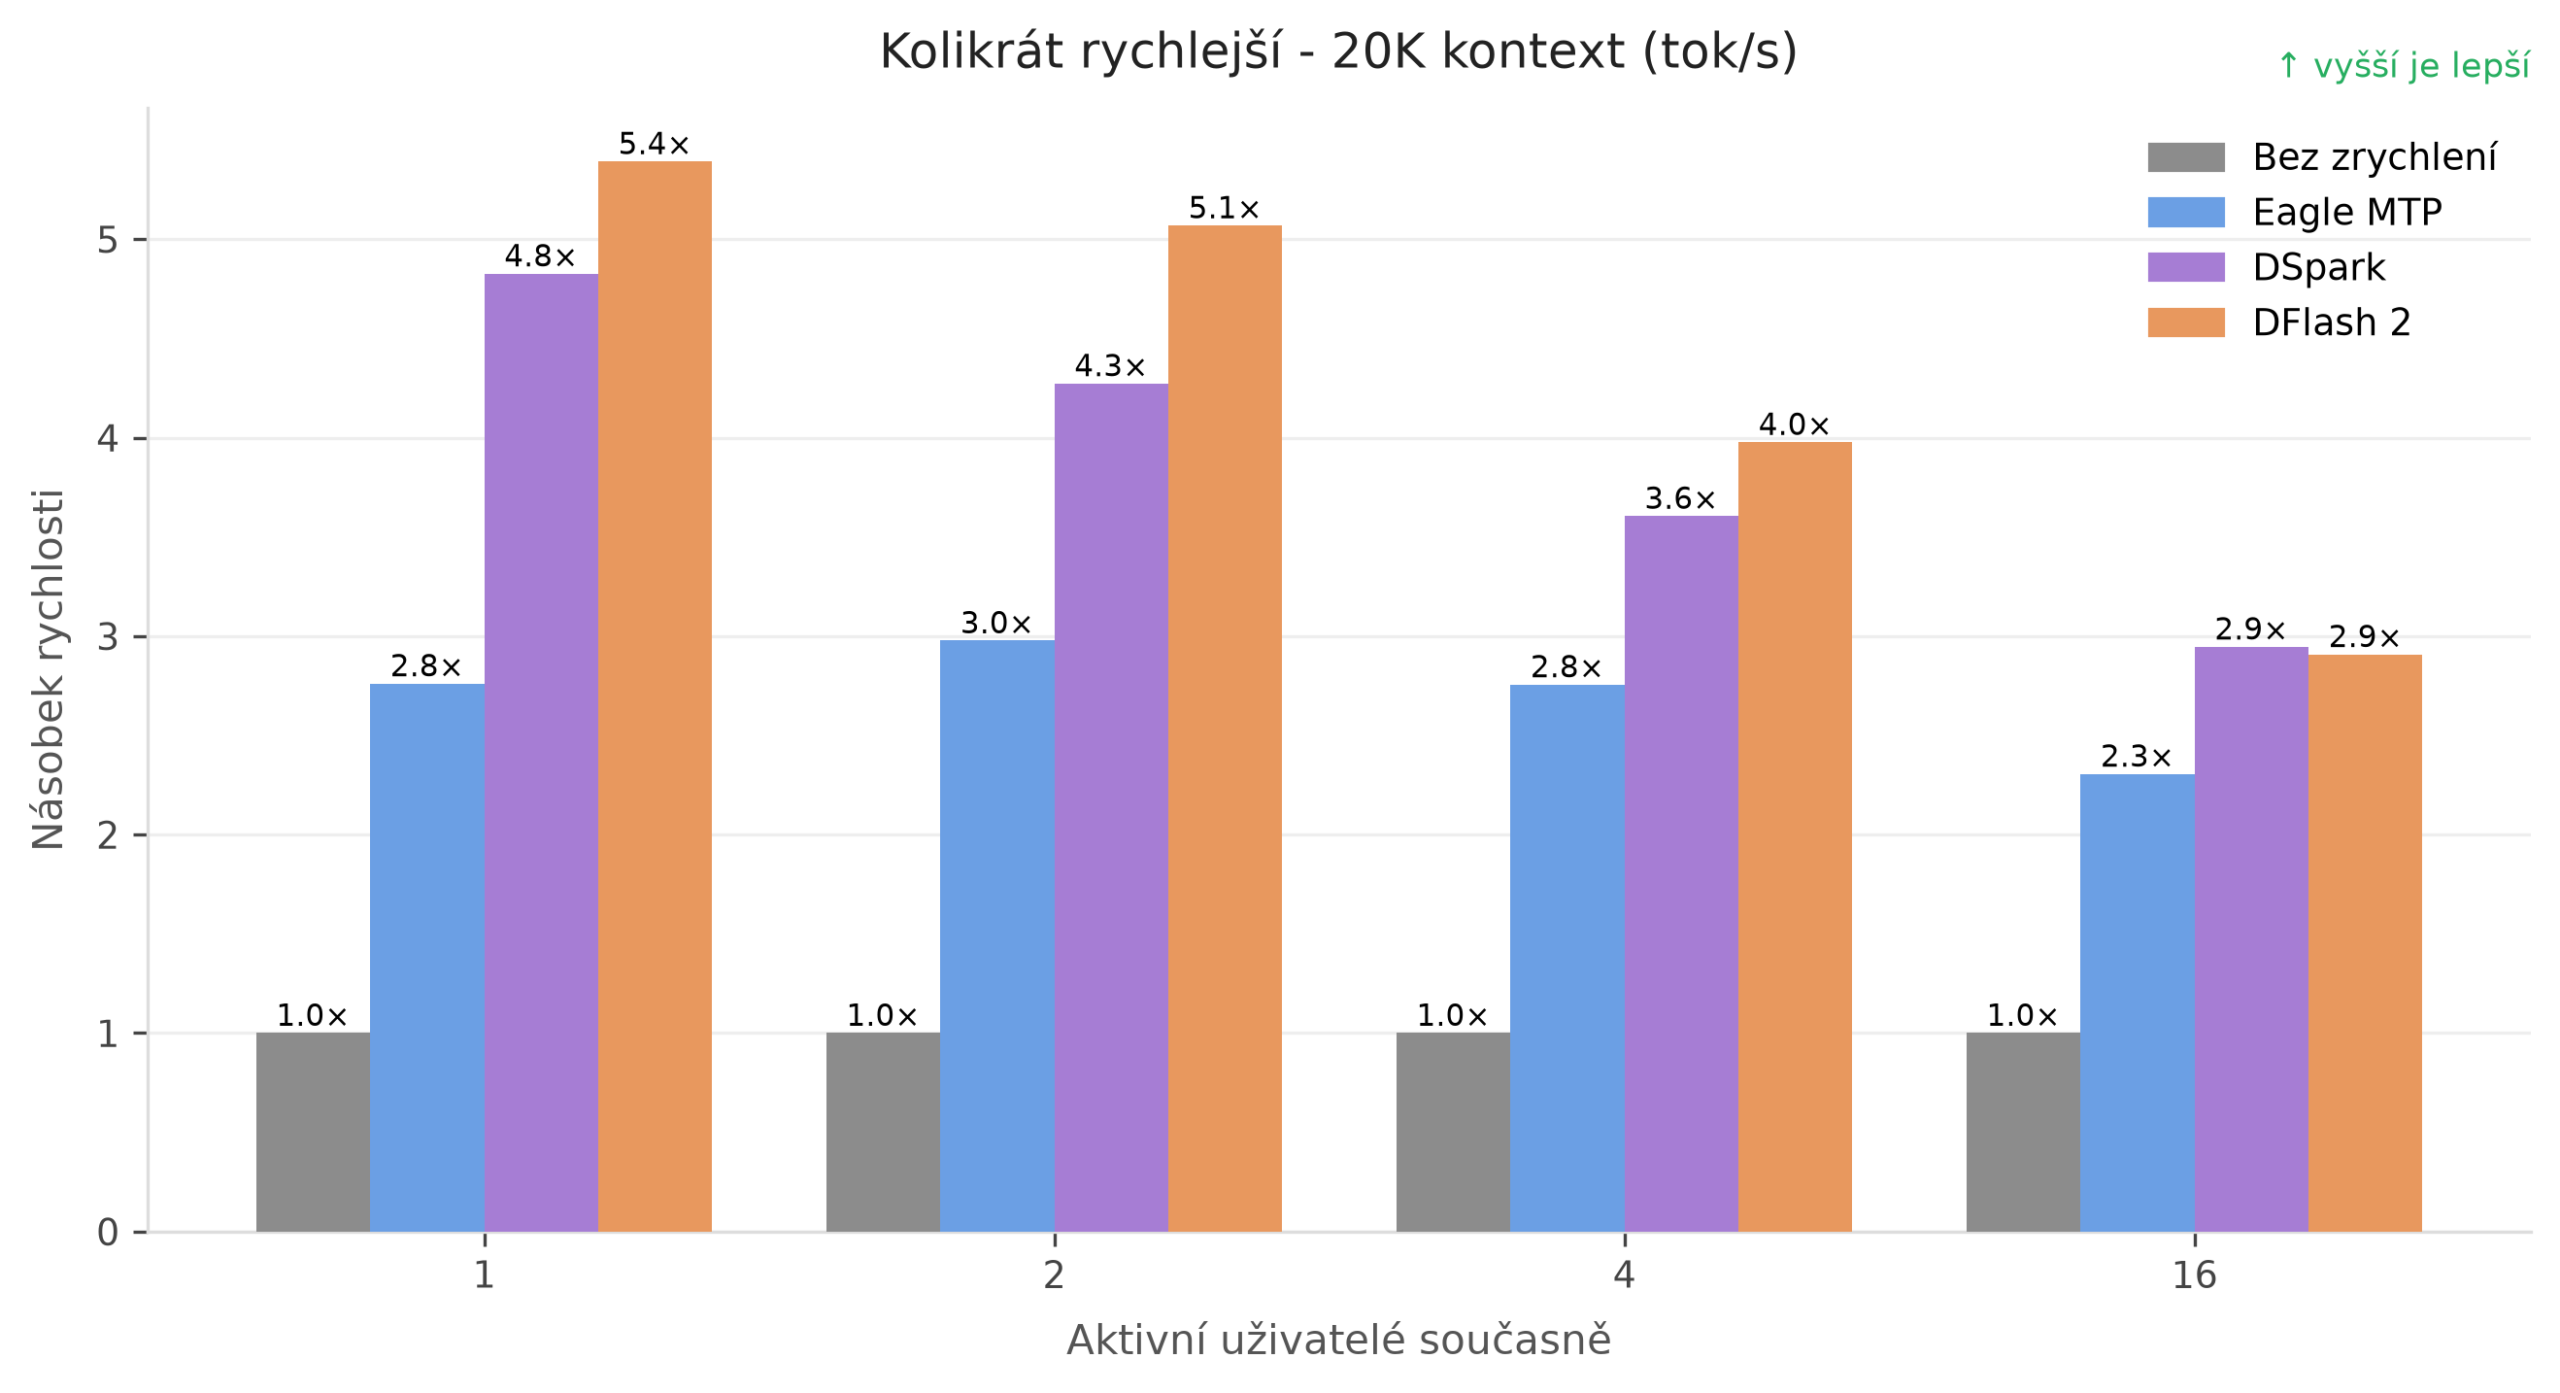
S rostoucí zátěží se jejich náskok zmenšuje, zrychlení se však projevilo ve všech měřených případech. DFlash 2 dosahuje při jednom uživateli přibližně 5,4násobné rychlosti. I při nejvyšší souběžnosti je Eagle MTP, nejpomalejší z testovaných metod, přibližně 2,3krát rychlejší než generování bez zrychlení.
Výhody a nevýhody jednotlivých variant
1) Bez zrychlení: jednoduchý provoz a záložní řešení
- Nejjednodušší konfigurace – méně součástí, které musíte ladit a kontrolovat.
- Vhodný kontrolní bod – ověříte, zda vám konkrétní zrychlení skutečně pomáhá.
- Nejnižší naměřený výkon
2) Eagle MTP: nejednodušší setup
- Bez externího návrhového modelu – MTP je součástí modelu.
- Zrychlení zůstavá stabilní po celý test
- Nižší rychlost než obě externí varianty
- Nutná podpora výrobce modelu
3) DSpark: silná volba pro více současných požadavků
- Nejvyšší celkový výkon při osmi a 16 uživatelích
- Stabilní rychlost při dlouhém kontextu
- Potřebujete kompatibilní návrhový model
- Slabší výsledek při malé souběžnosti
4) DFlash 2: nejrychlejší pro menší počet uživatelů
- Nejvyšší rychlost při malé souběžnosti
- Konkurenceschopný i při dlouhém kontextu
- Potřebujete kompatibilní návrhový model
- Nejvyšší souběžnost není jeho nejsilnější bod
5) Paměť a režie: vyšší rychlost není zadarmo
Abychom u zrychlených variant zachovali přibližně stejnou kapacitu KV cache jako při generování bez návrhů tokenů, potřebovali jsme zhruba 2 až 3 GB grafické paměti navíc. Paměťová cena byla u MTP, DSpark i DFlash 2 podobná.
Testovací prostředí a kompletní výsledky
1) Hardware, model a engine
| Parametr | Testovaná hodnota |
| Cílový model | Qwen/Qwen3.8-27B-FP8 |
| GPU | 1× NVIDIA RTX PRO 6000 Blackwell, 96 GB |
| Engine | SGLang v0.5.20-cu130, oficiální kontejner |
| KV cache | FP8 E4M3 |
| Attention backend | FlashInfer |
| mamba-full-memory-ratio | 3,67 pro variantu bez zrychlení a Eagle MTP;
11,01 pro DSpark a DFlash 2 |
| Mamba radix strategie | extra_buffer_lazy |
| SSM stavy | FP32 |
| Chunked prefill | 2 048 tokenů |
| Prefill CUDA graphs | vypnuto |
| Maximální počet požadavků | 16 |
2) Paměťové nastavení a kapacita KV cache
Parametr mem-fraction jsme pro každou variantu upravili tak, aby velikost KV poolu zůstala přibližně stejná. Konfigurace se spekulací zabírali o 2,3 až 2,6 GiB více než varianta bez zrychlení.
| Konfigurace | mem-fraction | KV pool | Obsazená paměť GPU v klidu |
| Bez zrychlení | 0,850 | 362 330 | 84,3 GiB |
| Eagle MTP | 0,905 | 363 329 | 86,8 GiB |
| DSpark (dspark7) | 0,855 | 361 497 | 86,9 GiB |
| DFlash 2 | 0,857 | 361 524 | 86,6 GiB |
3) Nastavení spekulativních variant
Eagle MTP: vestavěná návrhová část Qwenu, konfigurace se třemi kroky a čtyřmi draft tokeny, oficiální postup.
DSpark: návrhový model RadixArk/Qwen3.8-27B-DSpark. Návrhový blok o sedmi tokenech, oficiální postup.
DFlash 2: návrhový model z-lab/Qwen3.8-27B-DFlash2, paralelní návrh osmi tokenů a následné ověření, oficiální postup.
4) Vstupní zátěž a měření
Každý požadavek dostal stejný prompt. Ten obsahoval technický text o přibližně 20 000 nebo 200 000 tokenech a končil pokynem „output only code, no prose“. Režim přemýšlení byl vypnut. Výstup měl vynucenou délku 2 048 tokenů.
Měření používalo oficiální benchmark sglang.benchmark.serving a nativní rozhraní /generate. Před každým měřeným bodem proběhl jeden zahřívací požadavek.
5) Úplná naměřená propustnost
| Kontext | Požadavky | Bez zrychlení | Eagle MTP | DSpark | DFlash 2 |
| 20k | 1 | 46 | 127 | 222 | 248 |
| 20k | 2 | 88 | 262 | 376 | 446 |
| 20k | 4 | 172 | 474 | 620 | 684 |
| 20k | 8 | 328 | 820 | 1 232 | 1 084 |
| 20k | 16 | 576 | 1 328 | 1 697 | 1 675 |
| 200k | 1 | 39 | 108 | 224 | 222 |
Celková rychlost generování v tokenech/s. Označení kontextu odpovídá skupinám v grafech.
6) Použité modely
Qwen3.8-27B-FP8, RadixArk DSpark a z-lab DFlash 2.
Kterou variantu zvolit pro vaše nasazení
| Vaše priorita | Co vyzkoušet jako první |
| Zrychlení bez externího návrhového modelu | Eagle MTP |
| Nejvyšší rychlost pro 1 až 4 uživatele, 20k kontext | DFlash 2 |
| Celková propustnost pro 8 až 16 uživatelů, 20k kontext | DSpark, při 16 uživatelích porovnejte i téměř shodný DFlash 2 |
| Jeden uživatel, 200k kontext | DSpark nebo DFlash 2, výsledky jsou prakticky vyrovnané |
| Diagnostika nebo potíže s kompatibilitou | Varianta bez spekulativního dekódování |
Na naší sestavě se spekulativní dekódování vyplatilo ve všech měřených scénářích. Vyberte variantu podle počtu uživatelů a ověřte její přínos na vlastních úlohách.
Shrnutí: Jak zrychlit generování na stávajícím GPU
Největší rozdíl přináší přechod od běžného generování ke spekulativnímu dekódování. MTP se snadno nasazuje, DFlash 2 dosahuje nejvyšší rychlosti při menším počtu souběžných požadavků a DSpark si vede dobře při vyšší zátěži.
Vhodná metoda závisí na charakteru vašeho provozu. Správným nastavením můžete lépe využít výkon svého GPU serveru a zkrátit dobu odezvy bez nutnosti měnit grafickou kartu.