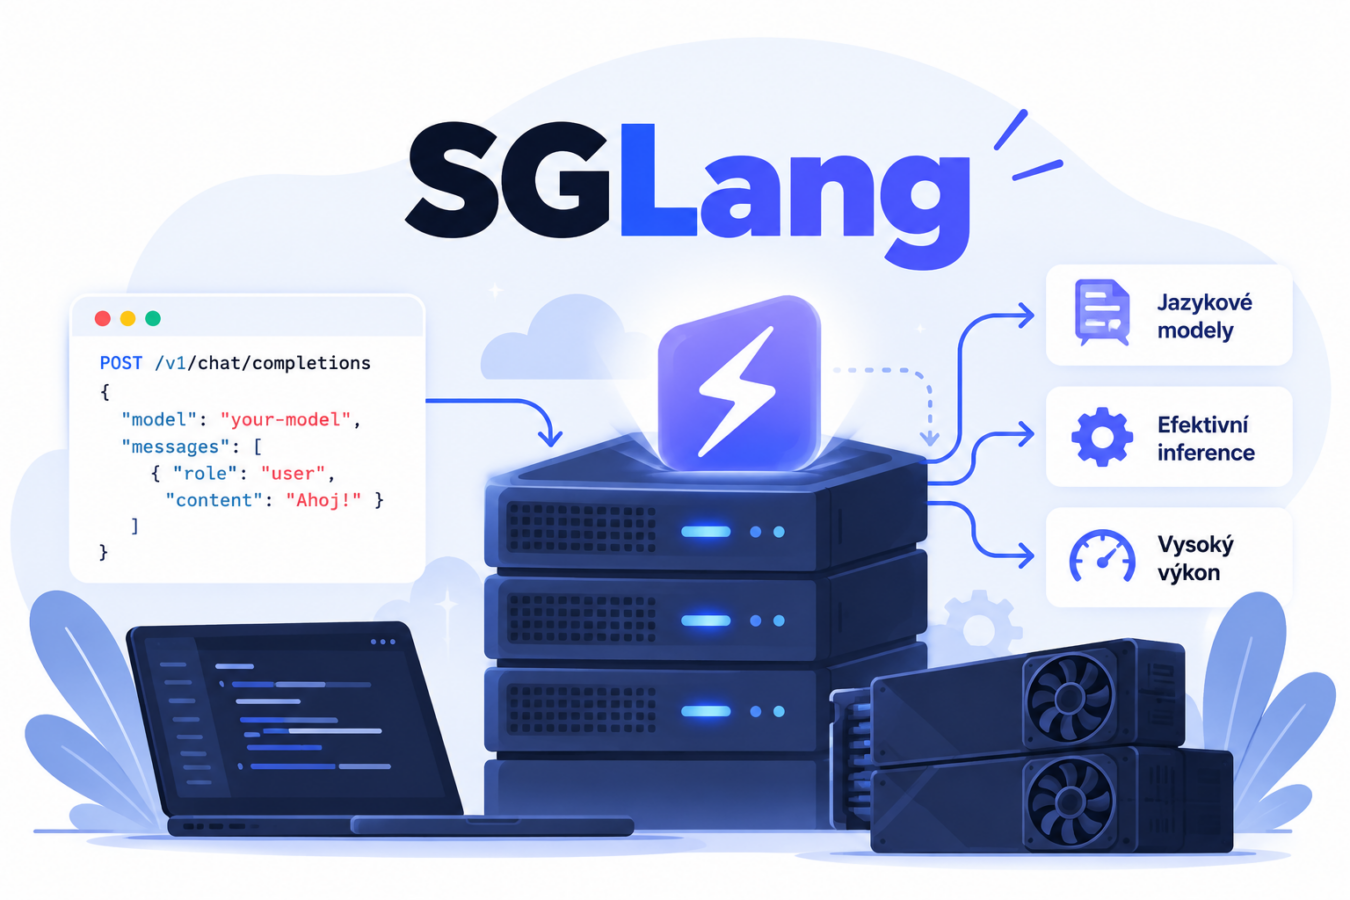
SGLang: Jak efektivněji provozovat jazykové modely na vlastním serveru
Rychlost AI aplikace nezávisí jen na zvoleném modelu nebo výkonu serveru. Důležité je také to, jak systém zpracovává požadavky, využívá paměť a předává výsledky dalším programům. SGLang pomáhá tyto úlohy řešit při provozu jazykových modelů na vlastní infrastruktuře. Jak funguje, čím může omezit zbytečné výpočty a kdy má smysl jej vyzkoušet?
Co je SGLang a kam patří v AI aplikaci
SGLang je open-source framework pro provoz jazykových a multimodálních modelů. Zajišťuje inferenci, tedy zpracování vstupů a vytváření odpovědí pomocí již natrénovaného modelu. Název vychází z označení Structured Generation Language. Projekt propojuje programové nástroje pro popis práce s modelem s běhovou vrstvou, která provádí potřebné výpočty, píše Digital Ocean.
V AI aplikaci funguje jako provozní vrstva mezi aplikací a modelem. Například u firemního asistenta aplikace přijme otázku, vyhledá relevantní dokumenty a sestaví požadavek. Ten odešle serveru se SGLang, který zajistí zpracování modelem a vrátí odpověď.
Jednotlivé části mají rozdílné úkoly. Model určuje kvalitu odpovědí, aplikace řeší uživatelské rozhraní, podklady a oprávnění. SGLang řídí obsluhu požadavků a využití výpočetních prostředků. Pomáhá zpracovávat více dotazů současně a opakovaně využívat výpočty pro společné části vstupů.
Podporuje například modelové rodiny Llama, Qwen nebo DeepSeek. Před nasazením je potřeba ověřit kompatibilitu konkrétního modelu, hardwaru a požadovaných funkcí.
RadixAttention: Společný začátek promptu stačí zpracovat jednou
AI aplikace často posílají modelu stále stejné úvodní instrukce. Zákaznický chatbot například při každém dotazu připojuje popis své role, pravidla komunikace a informace o produktu. Liší se až následná otázka.
Při zpracování vstupu vznikají mezivýsledky označované jako KV cache. SGLang je pomocí mechanismu RadixAttention uchovává a organizuje tak, aby je mohl využít také u dalších požadavků se společným začátkem.
Představme si dva prompty:
„Jste asistent e-shopu. Odpovídejte česky a stručně. Jak změním doručovací adresu?“
„Jste asistent e-shopu. Odpovídejte česky a stručně. Kde najdu fakturu?“
Úvodní instrukce jsou stejné. Pokud odpovídající cache zůstala dostupná, server může navázat na již provedené výpočty a zpracovat odlišnou část vstupu.
Nejde o ukládání hotových odpovědí. Model stále vytváří novou odpověď na aktuální otázku. Úspora vzniká při zpracování společné části promptu.
Rozhodující je shoda posloupnosti tokenů od začátku vstupu. Dva významově podobné, ale jinak formulované texty automaticky stejnou cache nesdílejí. Dostupná paměť je navíc omezená, takže uložené části mohou být postupně odstraněny.
Hlavní funkce SGLang pro provoz AI aplikací
1) Průběžné zpracování více požadavků
SGLang využívá techniku continuous batching, tedy průběžné sestavování dávek požadavků. Uživatelé posílají dotazy v různou dobu a odpovědi nemají stejnou délku. Server proto za běhu zařazuje nové požadavky do zpracovávané dávky a dokončené odebírá. Tím lépe využívá GPU i při nerovnoměrném provozu.
Na stejném hardwaru tak může zpracovat více práce než při postupné obsluze jednotlivých dotazů. Vyšší propustnost však automaticky neznamená rychlejší odpověď pro každého uživatele. Při rostoucí zátěži je potřeba sledovat také čekání ve frontě a dobu do prvního tokenu. Živý chat má v tomto ohledu jiné požadavky než noční zpracování tisíců dokumentů.
2) Strukturované výstupy pro automatizaci
Navazující software často potřebuje odpověď v přesně určené struktuře. Při získávání údajů z e-mailu může například očekávat JSON s číslem objednávky a typem požadavku:
{
„cislo_objednavky“: „20261005“,
„typ_pozadavku“: „zmena_adresy“
}
SGLang podporuje omezení generování pomocí JSON schématu, regulárního výrazu nebo gramatiky. Přípustná pokračování odpovědi se řídí zadanými pravidly, takže aplikace nemusí spoléhat pouze na instrukci „odpověz v JSON“.
Správný formát ale nezaručuje správný obsah. Model může uvést chybné číslo objednávky nebo nesprávně vyhodnotit požadavek. Ověření údajů zůstává úkolem aplikace, stejně jako řešení neúplných odpovědí a chybových stavů.
3) API pro propojení s aplikacemi
SGLang nabízí rozhraní kompatibilní s OpenAI API. Aplikace využívající odpovídající klientskou knihovnu tak může komunikovat s vlastním inference serverem prostřednictvím známého způsobu zadávání zpráv.
Kompatibilita rozhraní však neznamená totožné schopnosti modelů ani podporu všech funkcí externí služby. Při změně backendu je proto potřeba ověřit používané endpointy, parametry a podobu odpovědí.
Nasazení zahrnuje přípravu prostředí, instalaci SGLang, spuštění podporovaného modelu a odeslání testovacího požadavku. Projekt poskytuje dokumentaci i Docker obrazy. Pro produkční provoz je vhodné zvolit ověřenou verzi a doplnit řízení přístupu, monitoring a limity požadavků.
4) Správa paměťových nároků a kvantizace
Vedle výkonu rozhoduje také kapacita paměti GPU. Prostor zabírají váhy modelu, pracovní data i KV cache. S delším kontextem a větším počtem souběžných požadavků paměťové nároky rostou.
SGLang podporuje různé metody kvantizace, které používají nižší číselnou přesnost. Mohou snížit paměťové nároky a u vhodné kombinace modelu a hardwaru také zrychlit výpočty. Výsledek však závisí na konkrétní metodě a její podpoře na daném zařízení.
Při výběru konfigurace je proto vhodné hodnotit nejen spotřebu paměti a rychlost, ale také kvalitu češtiny, přesnost získaných údajů a úspěšnost při skutečných úlohách aplikace.
Kdy má smysl SGLang vyzkoušet
Z popsaných mechanismů vyplývá, že zajímavým scénářem jsou aplikace s opakujícími se instrukcemi, více souběžnými uživateli nebo strojově zpracovávanými výstupy. Může jít o zákaznického asistenta, třídění dokumentů nebo modelovou službu využívanou AI agentem.
Přínos je potřeba ověřit na reprezentativním provozu. Test by měl zahrnovat skutečné délky vstupů a odpovědí, očekávanou souběžnost i situace s dostupnou a prázdnou cache. Sledovat se vyplatí celkovou propustnost, dobu do prvního tokenu, délku dokončení odpovědi a chybovost.
SGLang pomáhá řešit provozní stránku vlastní AI. Pokud má firma vybraný model, jehož schopnosti odpovídají jejím potřebám, může prostřednictvím této vrstvy lépe využít dostupný hardware a propojit generování s dalšími aplikacemi. O skutečném přínosu rozhodne konkrétní zátěž a měření.