Obsah
Související
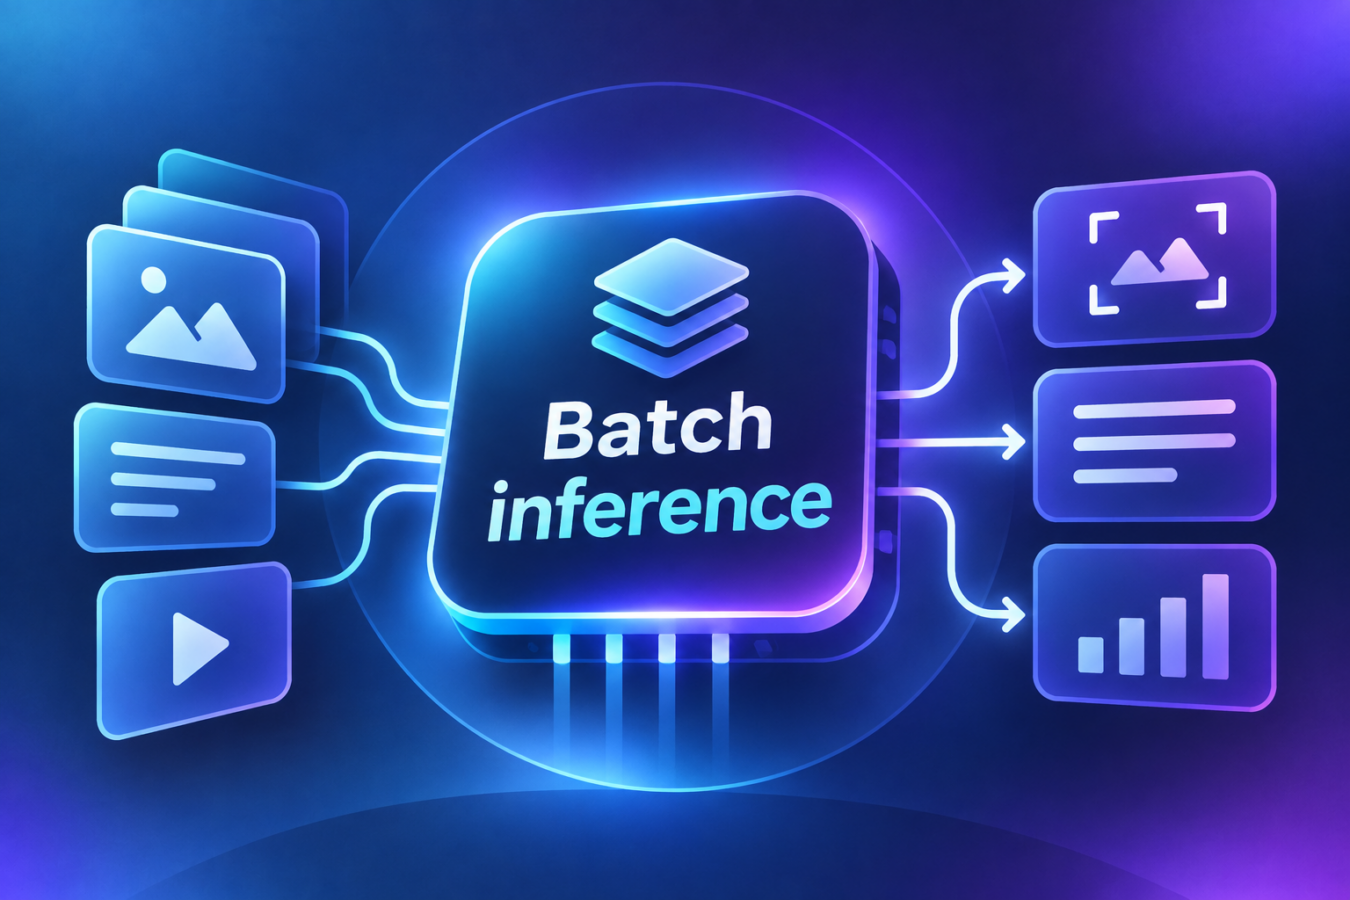
Potřebujete pomocí AI roztřídit tisíce zákaznických zpráv, vytáhnout údaje z dokumentů nebo doplnit popisy produktů v e-shopu? Pokud výsledek nemusí být k dispozici hned, nemusíte každou úlohu posílat samostatně a čekat na okamžitou odpověď. Batch inference (česky dávková inference) umožňuje předat modelu větší sadu požadavků jako jednu dávku a výsledky zpracovat později.
Co znamená batch inference
Inference je fáze, kdy natrénovaný model dostává vstupní data a vytváří výstup – například klasifikuje text, shrnuje dokument nebo předpovídá hodnotu. U batch inference, označované také jako dávkové či offline zpracování, se větší množství vstupů zpracovává hromadně. Výsledky se vracejí až po dokončení úlohy, nikoli okamžitě po každém požadavku, píše web Digital Ocean.
Typickým příkladem je e-shop, který chce vygenerovat krátké popisy pro celý katalog. Místo toho, aby systém posílal modelu jeden produkt za druhým během návštěvy zákazníka, připraví seznam položek a nechá je zpracovat v dávce.
Obdobně lze roztřídit starší zákaznické požadavky, shrnout archiv dokumentů nebo vyhodnotit rozsáhlou sadu testovacích úloh.
Jak batch inference probíhá
Batch inference většinou začíná přípravou dat. Provozovatel aplikace shromáždí úlohy, které chce modelu zadat, například zákaznické zprávy určené ke klasifikaci nebo popisy produktů, které je potřeba doplnit. Vstupy se obvykle ukládají do souboru či seznamu ve formátu podporovaném danou službou
1) Příprava vstupů – každý záznam by měl obsahovat samotný požadavek a jednoznačný identifikátor. Ten umožní později přiřadit odpověď ke správné zprávě, objednávce nebo položce katalogu. U větší dávky je také vhodné předem zkontrolovat, zda data mají správný formát a neobsahují prázdné nebo duplicitní záznamy.
2) Odeslání dávky – připravené požadavky se odešlou jako jedna úloha. Platforma může mít stanovený limit pro velikost souboru, počet záznamů nebo dobu, do které má být úloha dokončena. Tyto podmínky se liší podle poskytovatele, proto je potřeba je ověřit před odesláním.
3) Ověření a zařazení do fronty – služba nejprve zkontroluje, zda jsou vstupy platné a zda odpovídají požadovanému formátu. Pokud některý záznam nevyhovuje, může ho odmítnout nebo označit jako chybný. Zbývající požadavky zařadí do fronty, odkud je model postupně zpracuje podle dostupné kapacity.
4) Zpracování požadavků modelem – model nad jednotlivými vstupy provede požadovanou úlohu (například vytvoří shrnutí, vybere kategorii nebo vytáhne konkrétní údaje). Požadavky se mohou zpracovávat souběžně, ale uživatel obvykle nečeká na odpověď po každé položce. Výsledky získá až po dokončení celé úlohy nebo její části.
5) Stažení a přiřazení výsledků – po dokončení platforma zpřístupní výstupy, často jako soubor. Aplikace je podle identifikátorů propojí s původními vstupy a může je uložit do databáze, předat do analytického nástroje nebo připravit ke kontrole.
6) Kontrola chyb a výstupů – neúspěšné požadavky mohou být uvedeny odděleně od úspěšných odpovědí. Provozovatel tak může zjistit, které položky je potřeba opravit a odeslat znovu. U výsledků, které ovlivňují zákazníky nebo důležitá rozhodnutí, je vhodné zkontrolovat alespoň reprezentativní vzorek. Jazykový model může vytvořit přesvědčivě znějící, ale nesprávnou odpověď.
Konkrétní formát vstupů, limity i způsob předání výsledků se liší podle služby. Například Amazon SageMaker AI Batch Transform zpracovává data uložená v Amazon S3 a výsledné soubory ukládá zpět do určeného umístění v tomto úložišti.
Batch inference versus zpracování v reálném čase
Rozdíl mezi dávkovým a okamžitým zpracováním spočívá především v tom, kdy je potřeba odpověď. U inference v reálném čase aplikace odešle požadavek a čeká na odpověď modelu. Tento přístup se hodí například pro chatbot, doporučování produktů při prohlížení e-shopu nebo kontrolu formuláře při jeho odesílání.
Dávkové zpracování počítá s prodlevou. Uživatel nemusí čekat na jednotlivé výsledky a systém může vyřídit celou připravenou sadu později. AWS doporučuje Batch Transform pro situace, kdy jsou předem k dispozici velké objemy dat a není potřeba trvalý online endpoint.
| Vlastnost | Inference v reálném čase | Batch inference |
| Kdy přichází výsledek | Průběžně, po jednotlivých požadavcích | Po dokončení dávkové úlohy |
| Typické použití | Chatbot, doporučení, interaktivní funkce | Archivní data, katalogy, hromadné třídění |
| Hlavní výhoda | Rychlá odpověď pro uživatele | Efektivní zpracování většího objemu |
| Hlavní omezení | Systém musí rychle odpovídat při každém požadavku | Na výsledek je nutné počkat |
Kdy se batch inference vyplatí
Dávkové zpracování dává smysl zejména tehdy, když je úloh hodně, dají se zpracovat nezávisle na sobě a výsledek nemusí být okamžitý. Může jít například o:
- Třídění zákaznických zpráv podle tématu, naléhavosti nebo sentimentu.
- Zpracování dokumentů, například vytahování názvů, dat nebo částek ze smluv.
- Doplňování katalogu, například tvorbu štítků, krátkých shrnutí nebo návrhů popisků.
- Vyhodnocování modelů a promptů na rozsáhlé sadě předem připravených příkladů.
- Zpracování starších dat, která se nahromadila v systému a není nutné je analyzovat v okamžiku přijetí.
Pro dávkové zpracování vlastních AI modelů je potřeba také odpovídající výpočetní výkon. AI/GPU servery ZonerCloudu mohou sloužit ke spouštění AI aplikací a modelů na vlastní infrastruktuře. Uživatel si na serveru nastaví prostředí i způsob zpracování podle potřeb svého projektu.
Na co myslet před odesláním dávky
Batch inference usnadňuje práci s velkým množstvím požadavků, ale neznamená, že lze výsledky bez kontroly automaticky použít. Některé položky mohou při zpracování selhat, jiné mohou obsahovat nepřesnou nebo neúplnou odpověď. Před spuštěním celé dávky je proto vhodné ověřit, že vstupy mají správný formát a model správně chápe zadání.
Při přípravě a vyhodnocení dávky se vyplatí myslet na několik věcí:
- Jednoznačně označte každý vstup – použijte vlastní identifikátor, například číslo objednávky nebo ID dokumentu. Výsledky tak půjde spolehlivě propojit se správnými záznamy, i když je služba vrátí v jiném pořadí.
- Počítejte s chybami – zaznamenejte neúspěšné požadavky a zjistěte, zda je lze po opravě odeslat znovu. Selhání jedné položky nemusí znamenat, že je nutné opakovat celou dávku.
- Zkontrolujte vzorek výstupů – než výsledky uložíte nebo předáte dál, ověřte, zda odpovídají vstupům a zda je model správně vyhodnotil. U úloh, které ovlivňují zákazníky nebo důležitá rozhodnutí, může být potřeba kontrola člověkem.
- Stanovte, co se stane s nejistým výsledkem – pokud model nedokáže odpovědět nebo si není jistý, aplikace by měla takovou položku označit k ručnímu posouzení místo toho, aby s ní zacházela jako s ověřeným údajem.
Pozornost věnujte také datům, která modelu předáváte. Dokumenty a zákaznické zprávy mohou obsahovat osobní, důvěrné nebo jinak citlivé informace. Před odesláním externí službě proto zjistěte, jak poskytovatel s daty nakládá, kdo k nim může mít přístup a jak dlouho je uchovává. Pokud služba umožňuje odstranit údaje, které pro úlohu nejsou potřeba, například jména nebo kontaktní informace, zvažte jejich anonymizaci či vynechání.
U citlivých nebo regulovaných údajů je důležité prověřit také podmínky konkrétní služby a její nastavení zpracování. Rozhodnutí, jaká data lze předat, by mělo odpovídat interním pravidlům organizace i požadavkům, které se na dané údaje vztahují.
Když rychlost není prioritou
Batch inference pomáhá zpracovat velké množství úloh, které nemusí mít výsledek okamžitě. Uplatní se například při třídění archivních zpráv, doplňování produktových katalogů nebo testování modelů. Pokud ale na odpověď čeká uživatel přímo v aplikaci, například při chatu nebo vyhledávání, je vhodnější inference v reálném čase.
Při výběru tedy rozhoduje hlavně požadovaná rychlost odpovědi. Když může zpracování proběhnout na pozadí, dávkový přístup pomůže vyřídit mnoho požadavků v rámci jedné úlohy. Pro funkce, které mají reagovat bez čekání, zůstává vhodnější průběžné zpracování.